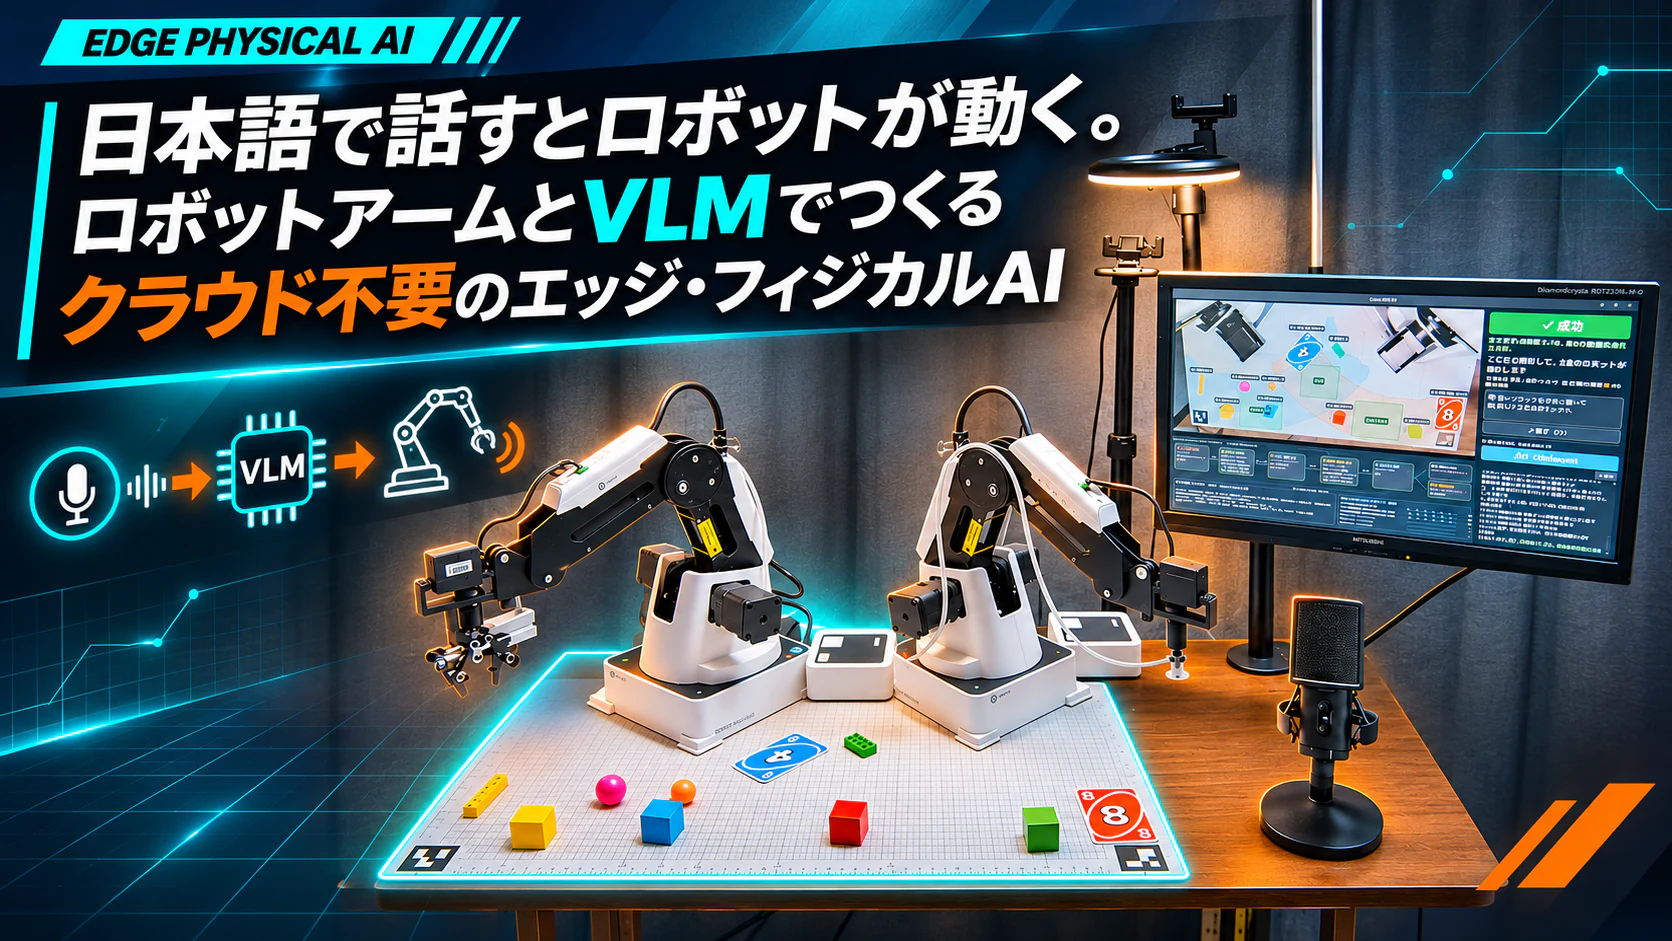
日本語で話すとロボットが動く。ロボットアームとVLMでつくるクラウド不要のエッジ・フィジカルAI
「赤いブロックを左のトレイに置いて」
座標や関節角を入力するのではなく、日本語でこう話しかけます。システムは作業台をカメラで確認し、対象のブロックを選び、置き場所と使う腕を決め、Dobot Magicianを動かします。動作後はもう一度カメラを見て、本当に置けたかまで確認します。
現在構築しているのは、日本語音声認識、追加学習した物体検出器、ローカルVLM、planner、ROS 2、2台のロボットアームを1台のエッジPCでつないだ卓上システムです。クラウドの推論APIへ音声や画像を送らず、認識・判断・制御をロボットのそばで実行します。
実際に日本語で指示し、2台のロボットアームが作業する様子を動画で確認できます。
1. 日本語をロボットが実行できる指示へ変える
利用者が伝えるのは「何を」「どうしたいか」です。
- 「黄色いボールを左のトレイに置いて」
- 「赤の4のカードを右のトレイに入れて」
- 「赤いブロックを左のトレイに置いて、その上に黄色いブロックを積んで」
- 「青いレゴを手前に3センチ動かして」
ロボットにとって、これらはまだ動作指令ではありません。画像のどれが対象か、どの道具なら扱えるか、どの腕が移動元と移動先の両方へ届くか、置き先に空きがあるか、といった判断が必要です。
そこで、日本語の発話をいきなりモーターへ渡さず、段階的に表現を変換します。
VLMの出力が、そのままモーターへ流れるわけではありません。VLMは画像と言葉を対応付けて作業の意味を解釈し、plannerが実行可能性を検証します。executorは検証済みの計画を、つかむ、持ち上げる、運ぶ、放す、といった具体的な動作へ展開します。
2. 左右のMagicianは同じ仕事を分けるだけではない
ハードウェアの中心は、俯瞰カメラ、マイク、エッジPC、2台のDobot Magicianです。左腕にはグリッパー、右腕には吸盤を取り付けています。
| 構成要素 | 採用しているもの | 役割 |
|---|---|---|
| エッジPC | Ubuntu 22.04、VRAM 8GB | 推論とロボット制御を1台に集約 |
| カメラ | 作業台を俯瞰する単眼カメラ | 現在の配置と動作後の状態を撮影 |
| 音声認識 | Haas-ja-v1.0 | 日本語の発話を指示テキストへ変換 |
| 物体検出 | 追加学習したRF-DETR-Seg Nano | 物体の種類と画像上の領域を認識 |
| VLM | Qwen3.5 9Bの量子化モデル、Ollama | 画像・物体一覧・指示から作業計画を生成 |
| ミドルウェア | ROS 2 Humble | 認識、計画、動作、状態を接続 |
| ロボット | Dobot Magician × 2 | グリッパーと吸盤で実物を操作 |
道具の違いは、腕の役割に直結します。薄いカードは吸盤、ボールや取っ手付きレゴはグリッパーというように、対象物ごとに扱い方が異なります。1台の腕では移動元と移動先の両方へ届かない場合には、両腕が届く場所へいったん置き、もう一方が取り直す受け渡し計画も使います。空中で直接手渡す方式ではありません。
3. 音声認識には作業台の語彙を教える
UIの「話す」ボタン、またはF2キーで録音を始めます。もう一度操作すると録音を終了し、16kHz・モノラルの音声をローカルの音声認識ワーカーへ渡します。認識結果は入力欄へ反映し、自動送信を有効にしていれば、そのまま実行要求へ進みます。自動送信を切れば、テキストを直してから送信できます。
一般的な日本語を文字にできても、この作業台で頻出する語を安定して認識できるとは限りません。そこで、次のような固有語彙を音声認識側へ与えています。
- 物体名:ブロック、レゴ、長いレゴ、取っ手付きレゴ、ボール、カード
- 置き場:左のトレイ、右のトレイ、中央
- 色:赤、青、緑、黄色、ピンク、オレンジ
- 操作:積んで、並べて、置いて
「取っ手付きレゴ」のような日常会話では頻度が低い言葉は、表記と読みを対応付けて認識時に強めます。無音や小さな雑音を指示として扱わないよう、録音が短すぎる場合や発話なしと判定した場合はテキストを生成しません。
4. 物体検出と「扱い方の知識」を分ける
主な移動対象は、RF-DETR-Segへ追加学習させた6クラスです。
| クラス | 対象物 | 操作上の特徴 |
|---|---|---|
block | 色付きの木製立方体 | 約25mm角。側面を挟むか上面を吸う候補 |
lego | LEGO 2×4 | 短辺をグリッパーで挟む。上面に突起がある |
long_lego | LEGO 1×6 | 細長く、把持方向が効く |
ball | スーパーボール | グリッパーで扱い、積み上げ対象にはしない |
card | UNOの数字カード | 薄いため吸盤で扱い、色と数字で指定できる |
handle | 取っ手付きレゴ | 本体ではなくリング状の取っ手を挟む |
学習時には実物を撮影し、クラスと領域をラベル付けしてモデルを更新します。実行時は、その学習済み重みで現在のカメラ画像を推論します。
検出器が答えるのは、主に「何が、画像のどこにあるか」です。それだけでは、どこをつかむか、吸盤を使えるか、積み上げてよいかは分かりません。物体の寸法、対応する道具、上面の形状、積み上げ可否、特殊な把持位置は、別の物体カタログ config/objects.yaml に持たせています。
画像認識の知識と、物理的な扱い方の知識を分けることで、検出クラスへすべての制御情報を押し込まずに済みます。
5. perceptionが画像を「作業に使える物体一覧」へ変える
ROS 2のcamera_nodeから画像を受け取ると、perceptionは検出結果だけでなく、色、輪郭、既知寸法、カメラの校正情報を統合します。後段へ渡す主な出力は次の2つです。
- 物体へ番号を描いた画像
- 番号、種類、色、位置、向き、段数、利用可能な道具を含む物体一覧
概念的な1物体分のデータは、次のようになります。
{
  "id": 3,
  "label": "block",
  "color": "red",
  "x_mm": 210.0,
  "y_mm": 290.0,
  "angle_deg": 12.0,
  "levels": 1,
  "tool": "both"
}
作業台には600×450mmのマットを置き、その奥・左を原点とします。xは右、yは手前、zはマット面から上です。画像の歪みとマット平面への対応を補正したうえで、それぞれのMagicianの座標系へ変換します。
対象を正しく選べても、把持点が数mmずれれば持ち上がりません。言語モデルの判断と同じくらい、どの座標系のどの点を使っているかが効きます。
積み上げでは下段の色や形が隠れます。そこでperceptionは、以前に見た積み上げとexecutorが行った操作も記録します。人が手で配置を変えれば記録と現実が食い違うため、変化に応じて記録を更新・破棄し、必要ならリセットできる構成です。
6. VLMは対象と作業順を決め、座標は決めない
VLMへ渡すのは、番号付き画像、perceptionの物体一覧、日本語の指示です。たとえば「赤いブロックを左のトレイに置いて、その上に黄色いブロックを積んで」という指示なら、「赤いブロック」が3番、「黄色いブロック」が7番だと画像と一覧から対応付けます。
出力は自由文ではなく、JSON Schemaで制約した作業計画です。
VLMが返す作業計画の例
{
  "reason": "赤いブロックを左のトレイに置き、その上に黄色いブロックを積む",
  "understanding": [
    {
      "phrase": "赤いブロック",
      "obj": 3,
      "to": "left_tray",
      "on": -1
    },
    {
      "phrase": "黄色いブロック",
      "obj": 7,
      "to": "on_object",
      "on": 3
    }
  ],
  "plan": [
    {"skill": "place", "obj": 3, "target": "left_tray"},
    {"skill": "stack", "obj": 7, "on": 3}
  ]
}
これはデータ構造を説明する例です。VLMは関節角や把持座標を直接出しません。
VLMが担当するのは「どの物を、何のために、どの順番で扱うか」です。利用できる高レベルのスキルも、place、stack、unstack、move_relative、rotate、report、ask、go_homeに限定しています。
「それを片付けて」の「それ」が特定できない場合は、無理に動作を作らずaskを返します。現在の聞き返しや報告はUIのテキスト表示で、音声読み上げは前提にしていません。
7. plannerが意味と物理制約を検証する
もっともらしいJSONでも、そのまま実行できるとは限りません。plannerは、選んだ対象や色、カードの数字、置き先、移動方向、距離、回転指定が指示と合っているかを確認します。VLM自身が出したunderstandingとplanの整合性も検査します。
続いて、現実の制約を反映します。
- 対象にグリッパーと吸盤のどちらが使えるか
- 移動元と移動先の両方へ届く腕があるか
- 作業時と運搬時の高さが関節の可動範囲に入るか
- 置き先に空きがあり、積み上げ段数の上限を超えないか
- 死角やもう一方のロボット本体に近い領域を避けられるか
- 運搬中に物体の下側が既存の積み上げへ当たらないか
現在の設定では、計画上の問題があれば問題点を添えてVLMに1回だけ作り直させます。腕が届かない、置き場所がない、といった現実側の制約は、同じ条件で生成し直しても解消しません。その場合は再生成せず、実行できない理由をUIへ返します。
8. ROS 2とexecutorが計画を腕の動作へ展開する
ROS 2では、カメラ画像のような継続データをTopic、認識や計画の依頼をService、進捗と結果を伴う長い処理をActionで扱います。
| 接続先 | 方式 | 主な用途 |
|---|---|---|
/camera/image_raw | Topic | カメラ画像の配信 |
/perception/perceive | Service | 現在の画像から物体情報を取得 |
/planner/plan | Service | 指示文から検証済み計画を生成 |
/executor/run | Action | 計画から完了までの作業を実行 |
/magician1/PTP_action | Action | 左腕の移動 |
/magician2/PTP_action | Action | 右腕の移動 |
| 各腕の道具用Service | Service | グリッパー開閉、吸盤ON/OFF |
/executor/moved | Topic | 操作結果をperceptionの記録へ反映 |
VLMとは同じPC上のOllamaへHTTPで接続し、検出器や音声認識ワーカーとはローカルソケットで通信します。モデルを動かす環境まで無理にROS 2ノードへ統一せず、ロボット側との境界を明確にしています。
1回のplaceも、実際には道具の準備、対象上空への移動、下降、把持または吸着、持ち上げ、運搬、解放、待機位置への復帰、再認識という複数の処理です。executorは、対象物と道具に合わせてこの段取りを作ります。
依存関係のある処理は順番を守り、互いに独立した処理は腕と場所の条件が合えば並行に進めます。中央の共有ゾーンを通る動作にはロックを使い、2台が同時に同じ領域へ入らないようにします。ただし、これはあらゆる姿勢の完全な衝突回避を保証するものではありません。
9. フィジカルAIの核は、動かした後にもう一度見ること
ロボットが移動指令を受け付けたことと、物体を正しく運べたことは別です。指が空振りする、運搬中に落とす、置いた後にずれる、といったことが現実には起こります。
UIからの実行では、各ステップの後に新しい画像を取得し、再認識した対象が置き先付近にあるかを確認します。
確認に失敗した場合は、再認識結果から対象を探し直します。元の場所に残っていれば把持失敗、経路付近にあれば落下や配置ずれの可能性があります。見つかった位置に応じて、取りに行く座標、向き、積み上げ高さの見積もりを修正します。
現在の設定値は、置き先との距離許容が15mm、取り直しが最大2回です。これは制御パラメーターであり、ロボットの実測精度やシステム全体の成功率ではありません。確認も種類・色・位置が中心で、把持力、接触状態、積み上げの安定性まで直接測っているわけではありません。
結果確認では、認識要求を出した時刻より後のフレームを待ちます。古い画像を再利用すると、正常に動かした物まで元の場所にあると判断しかねません。画像が更新されなければ、認識失敗として扱います。センサー情報が本当に現在を表しているかを確かめる処理も、閉ループには欠かせません。
10. 限られたVRAMを時間で分けて使う
運用時の音声、画像、指示は外部の推論APIへ送りません。音声認識、検出器、VLM、計画、ROS 2制御がエッジPC内でつながります。Ollamaの接続先も127.0.0.1:11434です。
ただし、ローカル化すれば自動的に軽くなるわけではありません。VLM、検出器、音声認識を8GBのVRAMへ同時常駐させると、メモリを圧迫します。そこで、すべてを載せ続けず、必要な時間を分けています。
利用者が話している時間を、音声認識モデルの準備にも使います。検出器は独立したGPUワーカーに分け、腕が動いている間はUI向け認識を止めます。動く腕を物体と誤認しにくくすると同時に、不要なGPU処理を減らすためです。
クラウド推論を使わない構成には、外部回線へ依存しにくいこと、作業台の画像や発話を手元で処理できること、APIの従量課金を前提にしないことという特徴があります。その代わり、モデルの取得、計算資源、ロード時間、保守は手元の運用条件になります。
11. モデルの賢さより先に、数mmのずれが効くこともある
木製ブロックは約25mm角で、グリッパーの最大開きは約27.5mmです。 数字だけならつかめそうですが、片側の余裕は約1.25mmしかありません。位置や向きが少しずれると、指が側面ではなく角へ当たります。
そこで、実装では次のような補正も扱います。
- カメラと作業マットの対応付け
- 各Magicianの台の位置と向きの校正
- 道具の長さ、水平オフセット、グリッパー中心のずれ
- 手首角度に応じた、指が閉じる向きの補正
- 白飛びや色誤認を抑える露出固定と照明・色補正
- 腕を待機位置へ戻し、作業台を見やすくする配置
大きな画像を複数処理へ流すため、ROS 2の画像転送にはPC内の共有メモリ通信も用意しています。AIが正しい対象を選ぶことと、ロボットが正確に現実へ触れることは別の課題です。この間を、校正、座標変換、道具の補正、センサー更新でつなぎます。
12. 完全な汎用ロボットではなくても、知覚と行動は閉じられる
「フィジカルAI」というと、未知の環境で何でもこなす汎用ロボットや、画像と言葉から直接動作を生成する巨大な学習モデルを指すのかもしれません。
今回のシステムは、その段階にはありません。
主な対象物は事前に検出器へ学習させています。寸法や道具の情報も明示的に与えています。作業領域は決まったマット上で、使える操作も定義済みのスキルの範囲に限られます。
VLMは間違えることもありますし、画像認識も完璧ではありません。つかみ損ねや配置ずれがあり、再試行でも解決しない場合があります。
それでも、限られた条件になりますが、普通の日本語の指示に従いロボットが作業を行う。これは一種のフィジカルAIであると考えます。
- 現実を観測します。 カメラで、その時点の作業台を認識します。
- 人の意図を解釈します。 日本語音声を文字にし、画像と照合して作業へ変換します。
- 身体の制約を考慮します。 道具、到達範囲、置き場所、運搬条件を反映します。
- 物理世界へ作用します。 実物をつかみ、持ち上げ、運び、置きます。
- 作用の結果を観測し直します。 期待した状態との差を見て、次の動作につなげます。
完全ではなくても、知覚・判断・行動が実世界の中で閉じています。その小さなループを、手元のエッジで動かしています。 そこに、このシステムの価値があると考えています。
13. FAQ
- インターネット接続はまったく不要ですか?
- 運用時の音声認識、物体検出、VLM推論、計画、制御にクラウドAPIは使いません。ただし、初回のモデルや依存ライブラリの取得、ソフトウェア更新まで不要になるという意味ではありません。
- 未学習の物体も動かせますか?
- 補助機能はありますが、現在は単眼カメラで距離や高さを安定して求められないため、動作を保証していません。主な対象物は事前に追加学習し、寸法や道具の情報もカタログへ登録します。
- VLMがロボットの座標を直接決めますか?
- 決めません。VLMは対象と作業順を高レベルのスキルとして返します。plannerが意味と物理制約を検証し、executorと幾何処理が具体的な位置や腕の動作へ変換します。
- 失敗したら同じ動作を繰り返しますか?
- 動作後の新しい画像で対象を探し直し、位置、向き、高さの見積もりを修正してから再試行します。現在の取り直し上限は2回で、解決しなければ失敗理由を返して後続処理を見送ります。